Umí AI přečíst váš web? 13 kontrol
Nejlepší stránka na trhu je k ničemu, když se k ní crawlery ChatGPT, Claude a Perplexity nedostanou. 13 kontrol, většina oprav zabere minuty.
Můžete mít nejlepší stránku ve svém oboru a v ChatGPT, Claude nebo Perplexity přesto neexistovat. Ne kvůli obsahu. Kvůli tomu, že se k ní jejich crawlery nikdy nedostaly.
Postavil jsem nástroj zdarma, který to u jedné stránky zkontroluje asi za 20 sekund. Jako první jsem ho pustil na svůj vlastní web. Neprošel.
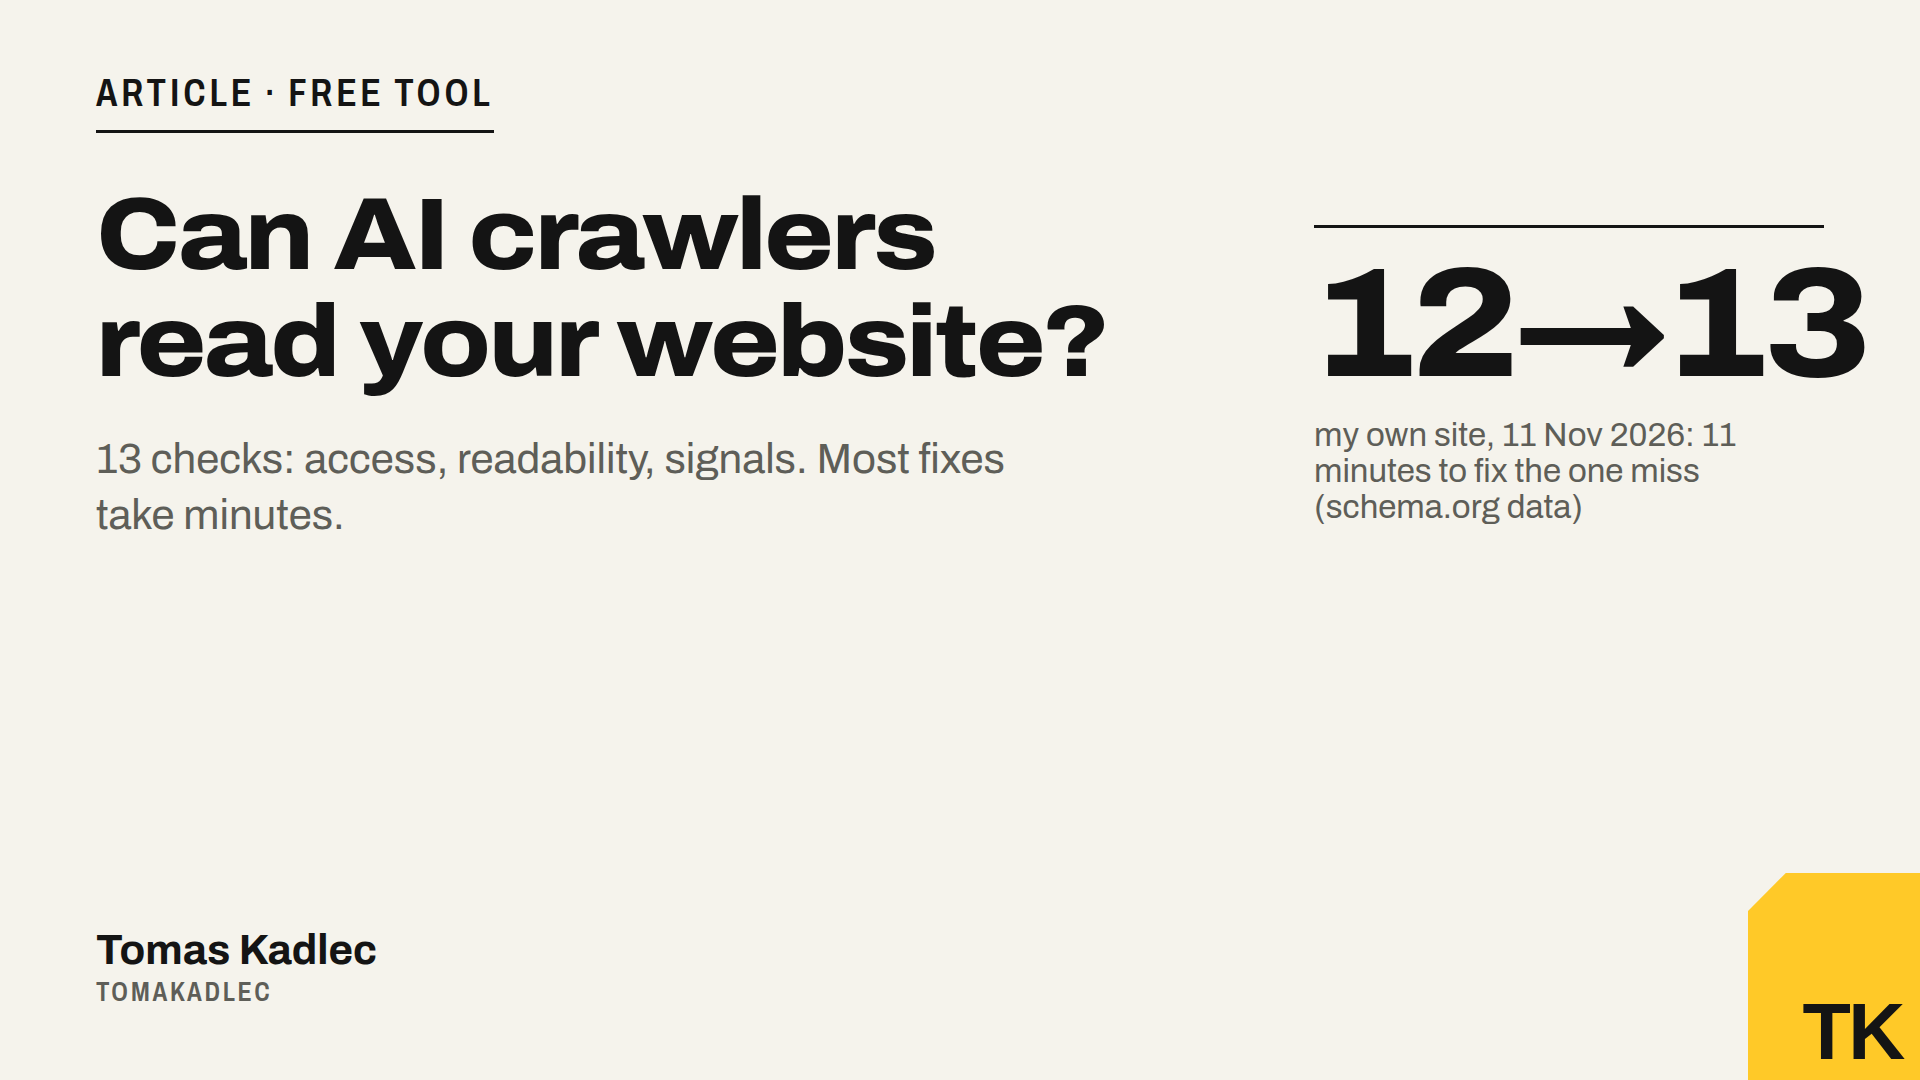
Můj vlastní web: 12 ze 13
- listopadu 2026 ve 14:35 ukázala kontrola na tomakadlec.com 12 ze 13. Chyběla jedna věc: strukturovaná data schema.org. Stránka byla čitelná, crawlery měly přístup, ale nic stroji neříkalo „tohle je člověk, tohle je služba, tohle je článek“.
Doplnil jsem JSON-LD na všechny stránky ve všech pěti jazycích. Ve 14:46 ukázala stejná kontrola 13 ze 13. Jedenáct minut. Většina oprav z tohoto seznamu je takhle malá, jakmile víte, že něco chybí.
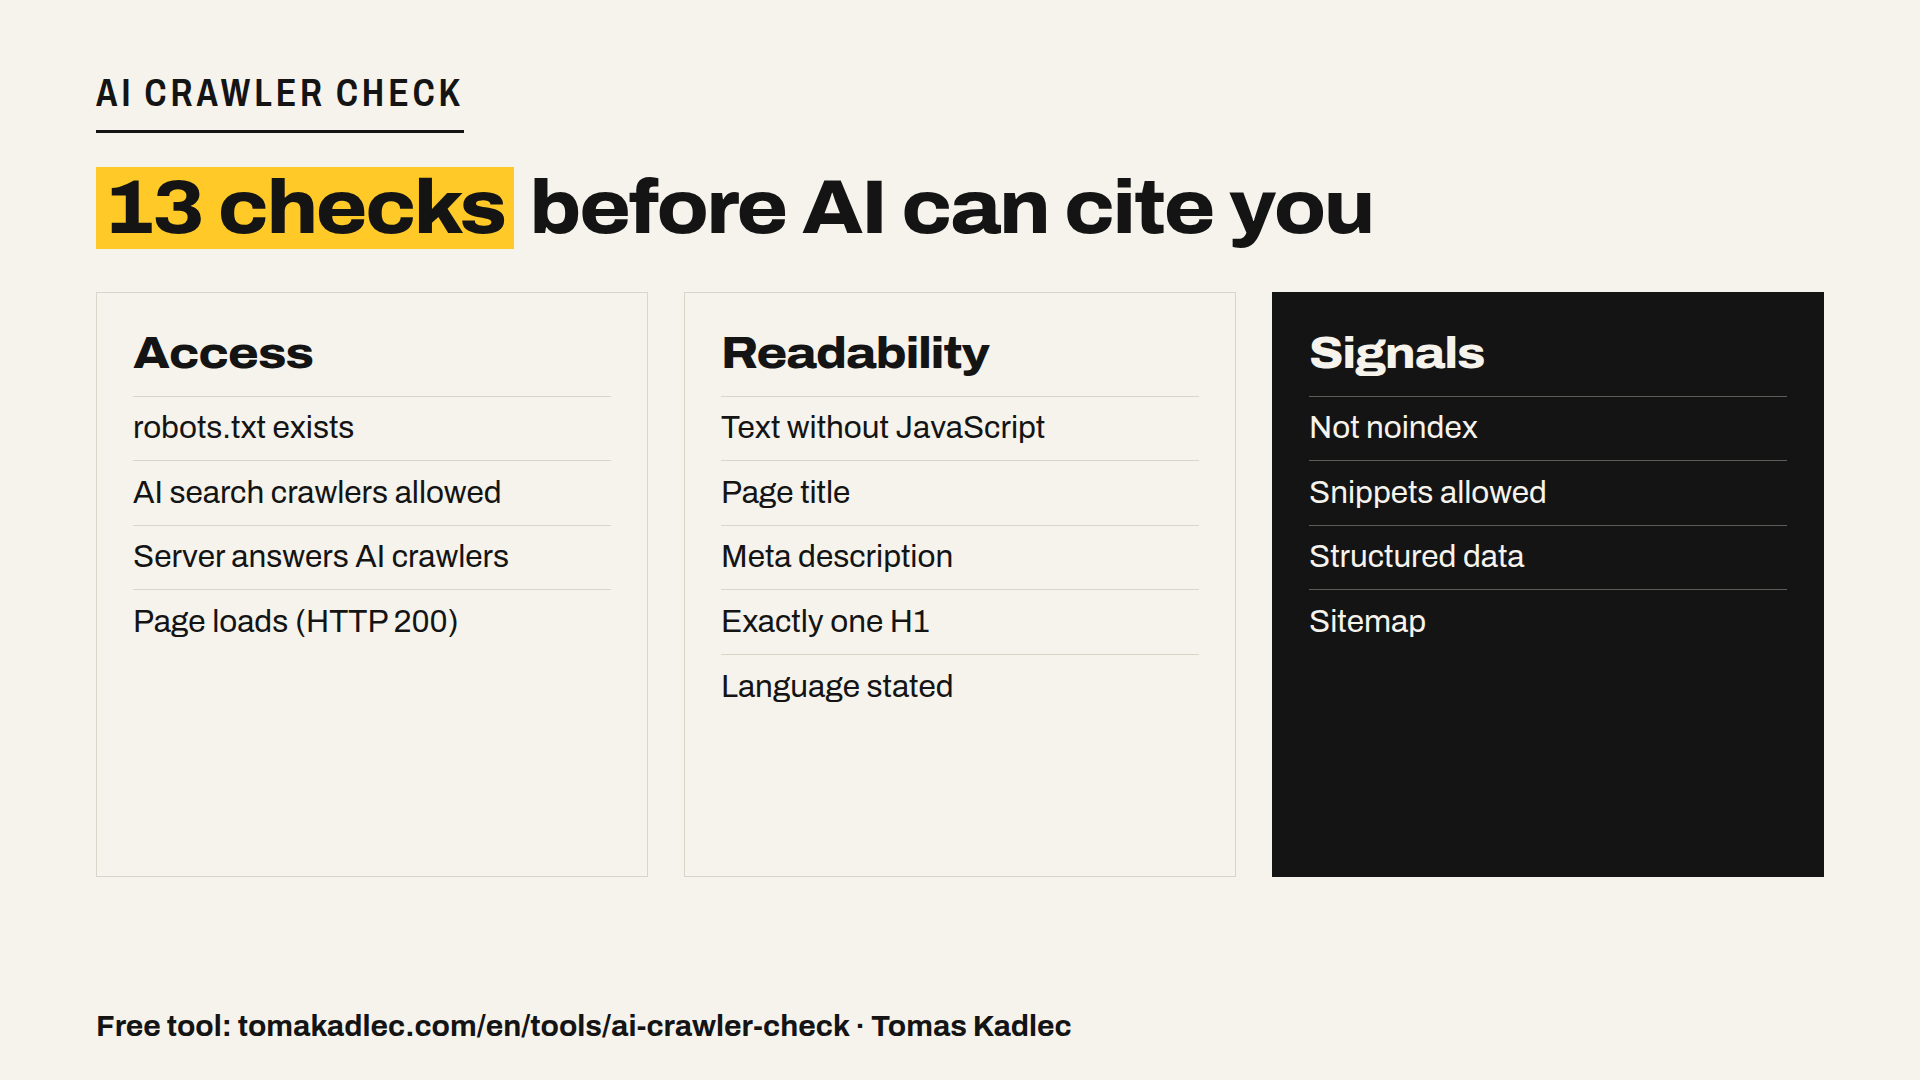
13 kontrol ve třech skupinách
Přístup: dostane se crawler dovnitř?
- Existuje robots.txt. Funkční soubor v kořeni domény. Když chybí nebo je rozbitý, chování crawlerů je nevyzpytatelné.
- AI vyhledávací crawlery mají povolený přístup. Nástroj čte robots.txt pro 16 AI crawlerů. Pro viditelnost jsou nejdůležitější vyhledávací crawlery jako OAI-SearchBot, Claude-SearchBot a PerplexityBot. Ty stahují stránky pro odpovědi AI vyhledávání.
- Server AI crawlerům odpovídá. Některé firewally a ochrany proti botům odmítnou každý požadavek, který obsahuje „GPTBot“ nebo „ClaudeBot“. robots.txt říká ano, server říká 403. Nástroj pošle požadavky s těmito jmény a porovná odpověď s běžným prohlížečem.
- Stránka se načte. HTTP 200. Zní to samozřejmě, ale viděl jsem řetězy přesměrování 301 a chyby 404 na stránkách, které „v prohlížeči fungují“.
Čitelnost: rozumí stránce?
- Text je čitelný bez JavaScriptu. Většina AI crawlerů JavaScript nespouští. Když se obsah objeví až po načtení skriptů, crawler vidí prázdnou stránku. Nástroj spočítá slova přímo v HTML.
- Titulek stránky.
- Meta description.
- Právě jeden nadpis H1.
- Jazyk uvedený v tagu html.
Signály: smí použít, co přečetl?
- Stránka není označená noindex. Zapomenutý noindex z testovacího webu stránku zabije ve vyhledávání i v AI vyhledávání.
- Úryvky jsou povolené. nosnippet nebo max-snippet:0 omezí, kolik z vás smí AI vyhledávání citovat.
- Strukturovaná data. JSON-LD schema.org podle toho, co stránka je: Organization, Person, Product, Article, FAQPage.
- Sitemap. Soubor sitemap.xml, ideálně uvedený v robots.txt.
Trénování a vyhledávání: jedno zakažte, druhé nechte
Spousta webů v letech 2023 a 2024 zablokovala „AI boty“ jedním řádkem na každého bota. Často tím zablokovala špatnou věc.
Velké AI firmy mají oddělené crawlery. GPTBot sbírá data pro trénování modelů. OAI-SearchBot stahuje stránky pro odpovědi ve vyhledávání ChatGPT. Anthropic má ClaudeBot pro trénování a Claude-SearchBot pro vyhledávání. Google-Extended řídí trénování Gemini, Googlebot zůstává vaším běžným vyhledávacím crawlerem.
Můžete tedy říct ne trénování a ano citacím:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
Nástroj u každého crawleru ukáže jeho účel (trénování, vyhledávání, nebo požadavek uživatele), takže vidíte, co váš robots.txt skutečně rozhoduje.
Dvě poctivá omezení. OpenAI a Perplexity uvádějí, že jejich nástroje spouštěné uživatelem (ChatGPT-User, Perplexity-User) se robots.txt řídit nemusí, protože o stránku požádal člověk. A testovací požadavky jdou z mého serveru, ne z IP adres samotných crawlerů. CDN, které IP adresy crawlerů ověřuje, tak může odpovědět jinak.
Co udělat tento týden
- Pusťte kontrolu na homepage a na stránku, která vám vydělává nejvíc.
- Nejdřív opravte všechno červené: zablokované vyhledávací crawlery, odmítnutí serverem, noindex, prázdné stránky bez JavaScriptu.
- Pak žluté: strukturovaná data, description, jeden H1, sitemap.
- O trénovacích crawlerech rozhodněte vědomě, ne náhodou.
- Pusťte kontrolu znovu po každé větší změně webu. Pluginy a nastavení CDN mění robots.txt a hlavičky, aniž by vám to řekly.
Krátce
Viditelnost v AI začíná dřív než obsah. Když se crawlery nedostanou dovnitř nebo stránku nepřečtou, na ničem dalším nezáleží. 13 kontrol, většina oprav zabere minuty.
Kontrola zdarma: AI crawler check na tomakadlec.com. Jedna URL, bez registrace. Celou zprávu s opravami vám pošle e-mailem, pokud chcete. Když něco neprojde a chcete to mít opravené, podívejte se na opravu čitelnosti pro AI nebo si domluvte 20minutový hovor zdarma.
Kterou ze 13 kontrol podle vás váš web neprojde?
Zdroje: vlastní běh AI crawler checku na tomakadlec.com, 11. 11. 2026 (12 ze 13 ve 14:35, 13 ze 13 ve 14:46) · seznam crawlerů ověřený 11. 11. 2026 v dokumentaci OpenAI, Anthropic a Perplexity · RFC 9309 (Robots Exclusion Protocol).