¿Pueden los rastreadores de IA leer su web? 13 comprobaciones
La mejor página de su mercado no sirve de nada si los rastreadores de ChatGPT, Claude y Perplexity no pueden entrar. 13 comprobaciones, la mayoría de arreglos llevan minutos.
Puede escribir la mejor página de su mercado y seguir siendo invisible en ChatGPT, Claude o Perplexity. No porque el contenido sea malo. Sino porque sus rastreadores nunca llegaron a leerlo.
Hice una herramienta gratuita que lo comprueba para una página en unos 20 segundos. Luego la pasé primero por mi propia web. Suspendió.
Mi propia web: 12 de 13
El 11 de noviembre de 2026 a las 14:35, la comprobación de tomakadlec.com dio 12 de 13. El único fallo: no había datos de schema.org. La página era legible y los rastreadores tenían permiso, pero no había datos estructurados que le dijeran a una máquina «esto es una persona, esto es un servicio, esto es un artículo».
Añadí JSON-LD a todas las páginas en los cinco idiomas. A las 14:46 la misma comprobación dio 13 de 13. Once minutos. La mayoría de arreglos de esta lista son así de pequeños cuando sabe lo que falta.
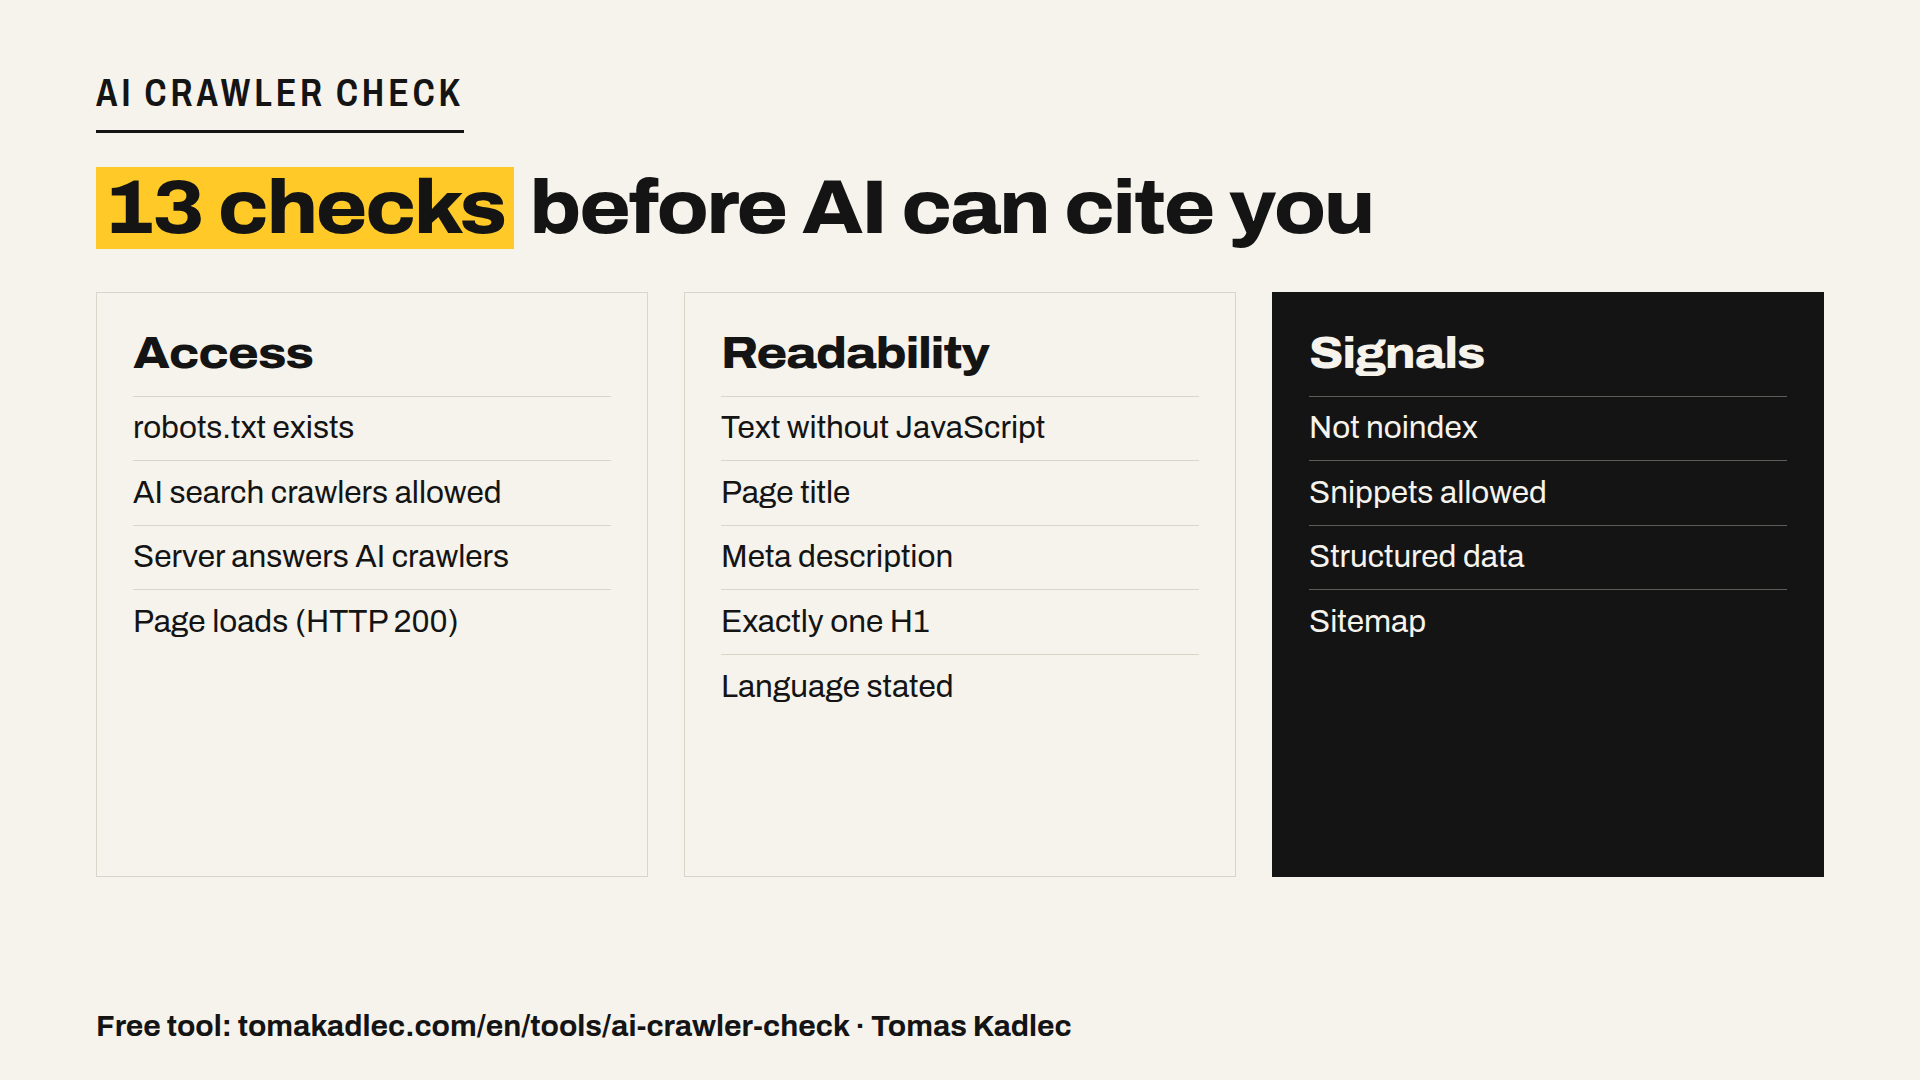
Las 13 comprobaciones, en tres grupos
Acceso: ¿puede entrar el rastreador?
- Existe robots.txt. Un archivo que funcione en la raíz del dominio. Si falta o está roto, el comportamiento de los rastreadores es impredecible.
- Los rastreadores de búsqueda de IA tienen permiso. La herramienta lee el robots.txt para 16 rastreadores de IA. Los que más importan para la visibilidad son los de búsqueda, como OAI-SearchBot, Claude-SearchBot y PerplexityBot. Descargan páginas para las respuestas de la búsqueda con IA.
- El servidor responde a los rastreadores de IA. Algunos cortafuegos y protecciones contra bots rechazan cualquier solicitud con «GPTBot» o «ClaudeBot». El robots.txt dice sí y el servidor dice 403. La herramienta envía solicitudes con esos nombres y compara la respuesta con la de un navegador normal.
- La página carga. HTTP 200. Parece obvio, pero he visto cadenas de 301 y errores 404 en páginas que «funcionan en el navegador».
Legibilidad: ¿entiende la página?
- Texto legible sin JavaScript. La mayoría de rastreadores de IA no ejecutan JavaScript. Si su contenido solo aparece después de cargar los scripts, el rastreador ve una página vacía. La herramienta cuenta las palabras que hay en el propio HTML.
- Título de la página.
- Meta description.
- Exactamente un H1.
- Idioma indicado en la etiqueta html.
Señales: ¿puede usar lo que ha leído?
- Sin noindex. Un noindex olvidado de un entorno de pruebas mata la página para la búsqueda normal y para la búsqueda con IA.
- Fragmentos permitidos. nosnippet o max-snippet:0 limitan cuánto puede citarle la búsqueda con IA.
- Datos estructurados. JSON-LD de schema.org según lo que sea la página: Organization, Person, Product, Article, FAQPage.
- Sitemap. Un sitemap.xml, idealmente indicado en el robots.txt.
Entrenamiento o búsqueda: bloquee uno y mantenga el otro
Muchas webs bloquearon los «bots de IA» en 2023 y 2024 con una línea por bot. A menudo bloquearon lo que no era.
Las grandes empresas de IA tienen rastreadores separados. GPTBot recoge datos para entrenar modelos. OAI-SearchBot descarga páginas para las respuestas de la búsqueda de ChatGPT. Anthropic tiene ClaudeBot para entrenamiento y Claude-SearchBot para búsqueda. Google-Extended controla el entrenamiento de Gemini, mientras Googlebot sigue siendo su rastreador de búsqueda habitual.
Así que puede decir no al entrenamiento y sí a que le citen:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
La herramienta muestra cada rastreador con su finalidad (entrenamiento, búsqueda o solicitud de un usuario), para que vea qué decide de verdad su robots.txt.
Dos límites, con honestidad. OpenAI y Perplexity dicen que sus consultas iniciadas por el usuario (ChatGPT-User, Perplexity-User) pueden no seguir el robots.txt, porque una persona pidió esa página. Y las solicitudes de prueba salen de mi servidor, no de las IP de los rastreadores. Una CDN que verifique esas IP puede responder de otra forma.
Qué hacer esta semana
- Pase la comprobación por su página de inicio y por la página que más vende.
- Arregle primero todo lo rojo: rastreadores de búsqueda bloqueados, rechazos del servidor, noindex, páginas vacías sin JavaScript.
- Luego lo amarillo: datos estructurados, description, un solo H1, sitemap.
- Decida sobre los rastreadores de entrenamiento a propósito, no por accidente.
- Vuelva a pasarla tras cada cambio grande en la web. Los plugins y la configuración de la CDN cambian el robots.txt y las cabeceras sin avisar.
Resumen
La visibilidad en IA empieza antes que el contenido. Si los rastreadores no pueden entrar o no pueden leer la página, nada más importa. 13 comprobaciones, la mayoría de arreglos llevan minutos.
Comprobación gratuita: AI crawler check en tomakadlec.com. Una URL, sin registro. El informe completo con los arreglos le llega por correo si lo quiere. Si algo falla y quiere que se lo arreglen, vea la reparación de legibilidad para IA.
¿Cuál de las 13 cree que suspenderá su web?
Fuentes: prueba propia del AI crawler check en tomakadlec.com, 11 de noviembre de 2026 (12 de 13 a las 14:35, 13 de 13 a las 14:46) · lista de rastreadores contrastada el 11 de noviembre de 2026 con la documentación de OpenAI, Anthropic y Perplexity · RFC 9309 (Robots Exclusion Protocol).