Können KI-Crawler Ihre Website lesen? 13 Prüfungen
Die beste Seite Ihres Marktes nützt nichts, wenn die Crawler von ChatGPT, Claude und Perplexity nicht hineinkommen. 13 Prüfungen, die meisten Korrekturen dauern Minuten.
Sie können die beste Seite in Ihrem Markt schreiben und trotzdem in ChatGPT, Claude oder Perplexity unsichtbar sein. Nicht weil der Inhalt schlecht ist. Sondern weil deren Crawler ihn nie lesen konnten.
Ich habe ein kostenloses Tool gebaut, das genau das für eine Seite in etwa 20 Sekunden prüft. Dann habe ich es zuerst auf meine eigene Website losgelassen. Sie ist durchgefallen.
Meine eigene Website: 12 von 13
Am 11. November 2026 um 14:35 zeigte der Check auf tomakadlec.com 12 von 13. Der eine Fehler: keine schema.org-Daten. Die Seite war lesbar, Crawler waren erlaubt, aber es gab keine strukturierten Daten, die einer Maschine sagen „das ist eine Person, das ist eine Leistung, das ist ein Artikel“.
Ich habe JSON-LD auf jeder Seite in allen fünf Sprachen ergänzt. Um 14:46 zeigte derselbe Check 13 von 13. Elf Minuten. Die meisten Korrekturen auf dieser Liste sind so klein, sobald man weiß, dass etwas fehlt.
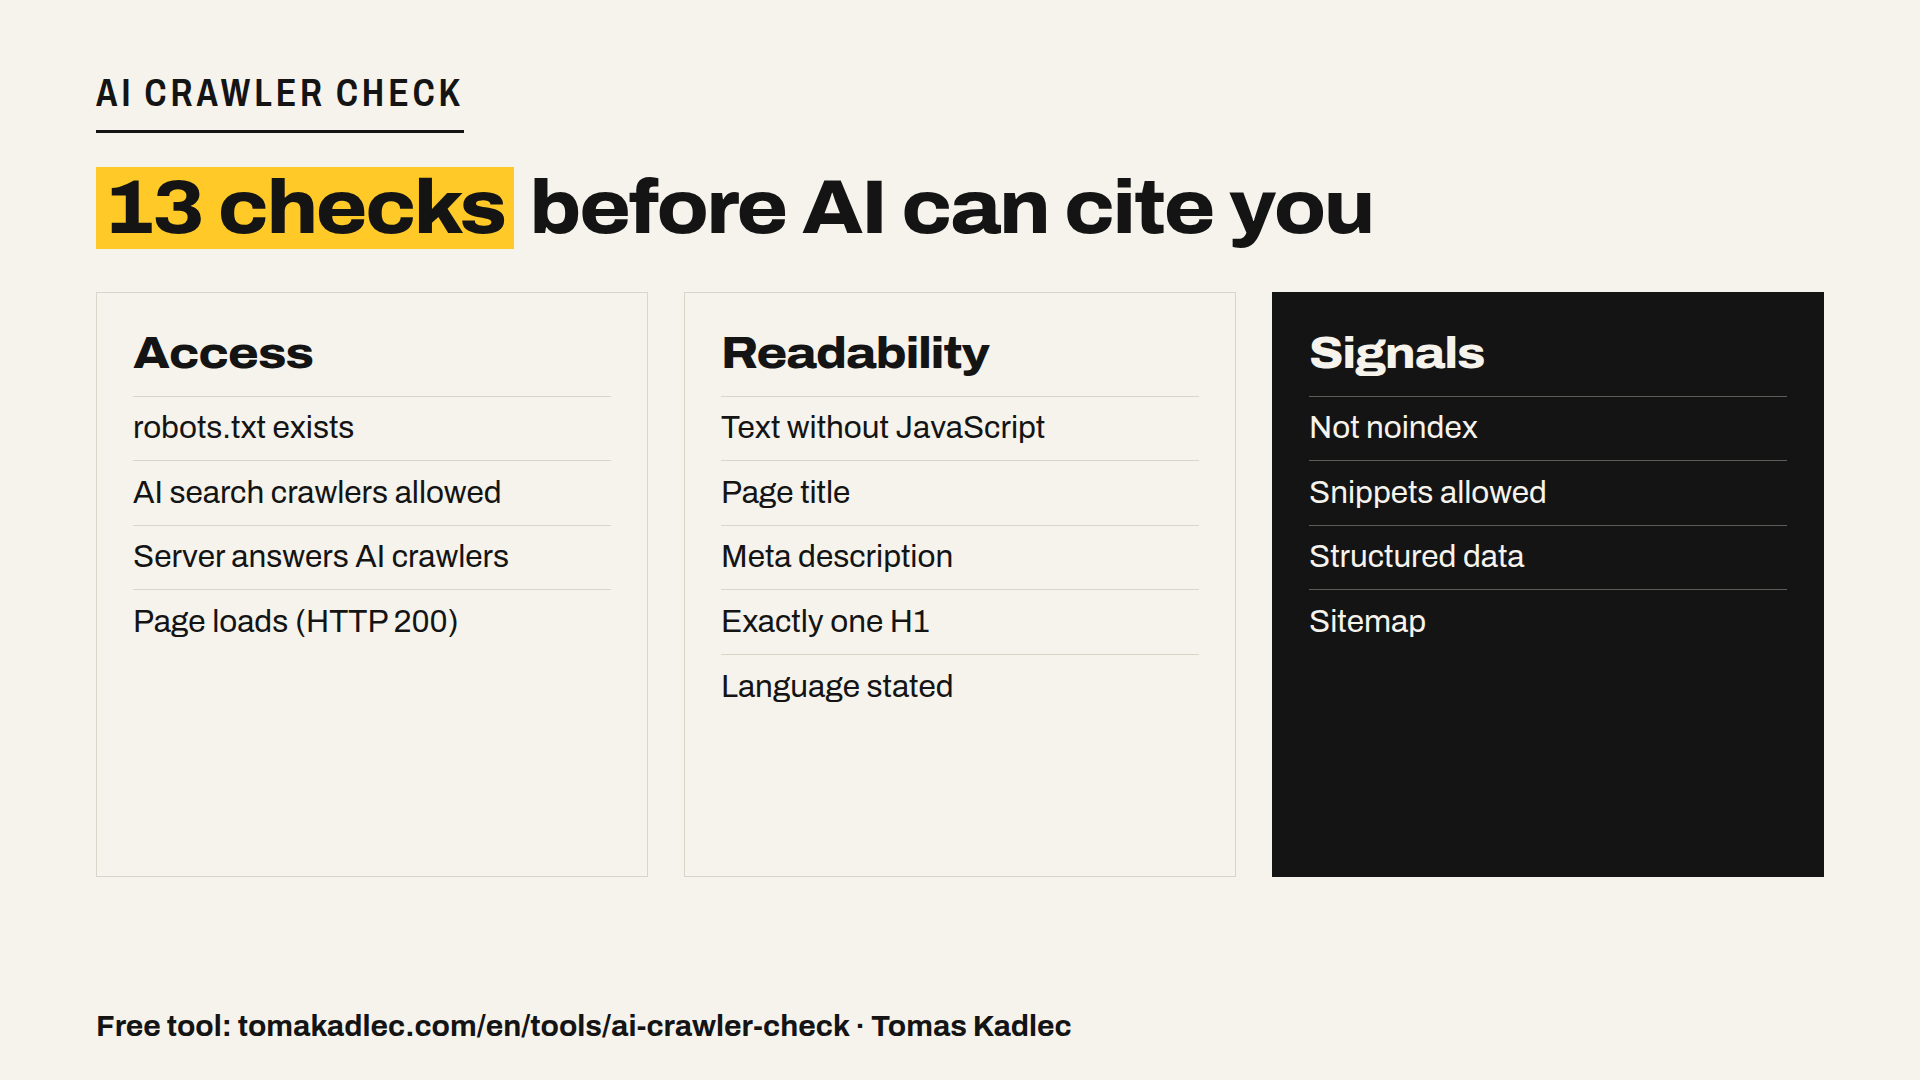
Die 13 Prüfungen in drei Gruppen
Zugang: Kommt der Crawler hinein?
- robots.txt existiert. Eine funktionierende Datei im Stammverzeichnis der Domain. Fehlt sie oder ist sie kaputt, wird das Verhalten der Crawler unberechenbar.
- KI-Such-Crawler sind erlaubt. Das Tool liest die robots.txt für 16 KI-Crawler. Für die Sichtbarkeit zählen vor allem Such-Crawler wie OAI-SearchBot, Claude-SearchBot und PerplexityBot. Sie holen Seiten für Antworten der KI-Suche.
- Der Server antwortet KI-Crawlern. Manche Firewalls und Bot-Schutzsysteme lehnen jede Anfrage mit „GPTBot“ oder „ClaudeBot“ ab. Die robots.txt sagt ja, der Server sagt 403. Das Tool schickt Anfragen mit diesen Namen und vergleicht die Antwort mit einem normalen Browser.
- Die Seite lädt. HTTP 200. Klingt selbstverständlich, aber ich habe 301-Ketten und 404 auf Seiten gesehen, die „im Browser funktionieren“.
Lesbarkeit: Versteht er die Seite?
- Text ohne JavaScript lesbar. Die meisten KI-Crawler führen kein JavaScript aus. Erscheint Ihr Inhalt erst nach dem Laden von Skripten, sieht der Crawler eine leere Hülle. Das Tool zählt die Wörter, die im HTML selbst stehen.
- Seitentitel.
- Meta Description.
- Genau eine H1.
- Sprache angegeben im html-Tag.
Signale: Darf er nutzen, was er gelesen hat?
- Nicht als noindex markiert. Ein vergessenes noindex von einer Testumgebung macht die Seite für Suche und KI-Suche gleichermaßen unsichtbar.
- Snippets erlaubt. nosnippet oder max-snippet:0 begrenzt, wie viel die KI-Suche von Ihnen zitieren darf.
- Strukturierte Daten. schema.org JSON-LD für das, was die Seite ist: Organization, Person, Product, Article, FAQPage.
- Sitemap. Eine sitemap.xml, idealerweise in der robots.txt genannt.
Training und Suche: das eine sperren, das andere behalten
Viele Websites haben 2023 und 2024 „KI-Bots“ mit einer Zeile pro Bot gesperrt. Oft wurde damit das Falsche gesperrt.
Die großen KI-Firmen betreiben getrennte Crawler. GPTBot sammelt Daten für das Modelltraining. OAI-SearchBot holt Seiten für Antworten in der ChatGPT-Suche. Anthropic hat ClaudeBot für das Training und Claude-SearchBot für die Suche. Google-Extended steuert das Training von Gemini, der Googlebot bleibt Ihr normaler Such-Crawler.
Sie können also Nein zum Training und Ja zum Zitiertwerden sagen:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
Das Tool zeigt jeden Crawler mit seinem Zweck (Training, Suche oder Nutzeranfrage), damit Sie sehen, was Ihre robots.txt tatsächlich entscheidet.
Zwei ehrliche Grenzen. OpenAI und Perplexity sagen, dass ihre vom Nutzer ausgelösten Abrufe (ChatGPT-User, Perplexity-User) sich nicht an die robots.txt halten müssen, weil ein Mensch die Seite angefragt hat. Und die Testanfragen kommen von meinem Server, nicht von den IP-Adressen der Crawler. Ein CDN, das Crawler-IPs prüft, kann also anders antworten.
Was Sie diese Woche tun
- Lassen Sie den Check auf Ihre Startseite und Ihre wichtigste Umsatzseite laufen.
- Beheben Sie zuerst jede rote Zeile: gesperrte Such-Crawler, Ablehnungen durch den Server, noindex, leere Seiten ohne JavaScript.
- Dann die gelben: strukturierte Daten, Description, eine H1, Sitemap.
- Entscheiden Sie über Trainings-Crawler bewusst, nicht aus Versehen.
- Lassen Sie den Check nach jeder größeren Änderung erneut laufen. Plugins und CDN-Einstellungen ändern robots.txt und Header, ohne es Ihnen zu sagen.
Zusammenfassung
KI-Sichtbarkeit beginnt vor dem Inhalt. Wenn Crawler nicht hineinkommen oder die Seite nicht lesen können, zählt nichts anderes. 13 Prüfungen, die meisten Korrekturen dauern Minuten.
Kostenloser Check: AI Crawler Check auf tomakadlec.com. Eine URL, keine Anmeldung. Den vollständigen Bericht mit Korrekturen gibt es per E-Mail, wenn Sie möchten. Wenn etwas durchfällt und Sie es behoben haben wollen, sehen Sie sich die Reparatur der KI-Lesbarkeit an.
Bei welcher der 13 Prüfungen erwarten Sie, dass Ihre Website durchfällt?
Quellen: eigener Lauf des AI Crawler Checks auf tomakadlec.com, 11. November 2026 (12 von 13 um 14:35, 13 von 13 um 14:46) · Crawler-Liste am 11. November 2026 abgeglichen mit der Crawler-Dokumentation von OpenAI, Anthropic und Perplexity · RFC 9309 (Robots Exclusion Protocol).