Les robots d'IA peuvent-ils lire votre site ? 13 contrôles
La meilleure page de votre marché ne sert à rien si les robots de ChatGPT, Claude et Perplexity n'y accèdent pas. 13 contrôles, la plupart des corrections prennent quelques minutes.
Vous pouvez écrire la meilleure page de votre marché et rester invisible dans ChatGPT, Claude ou Perplexity. Pas parce que le contenu est mauvais. Parce que leurs robots n'ont jamais pu le lire.
J'ai créé un outil gratuit qui vérifie cela pour une page en 20 secondes environ. Je l'ai d'abord lancé sur mon propre site. Il a échoué.
Mon propre site : 12 sur 13
Le 11 novembre 2026 à 14 h 35, le contrôle sur tomakadlec.com affichait 12 sur 13. Le seul raté : pas de données schema.org. La page était lisible, les robots étaient autorisés, mais aucune donnée structurée ne disait à une machine « ceci est une personne, ceci est un service, ceci est un article ».
J'ai ajouté du JSON-LD sur chaque page, dans les cinq langues. À 14 h 46, le même contrôle affichait 13 sur 13. Onze minutes. La plupart des corrections de cette liste sont aussi petites, une fois qu'on sait ce qui manque.
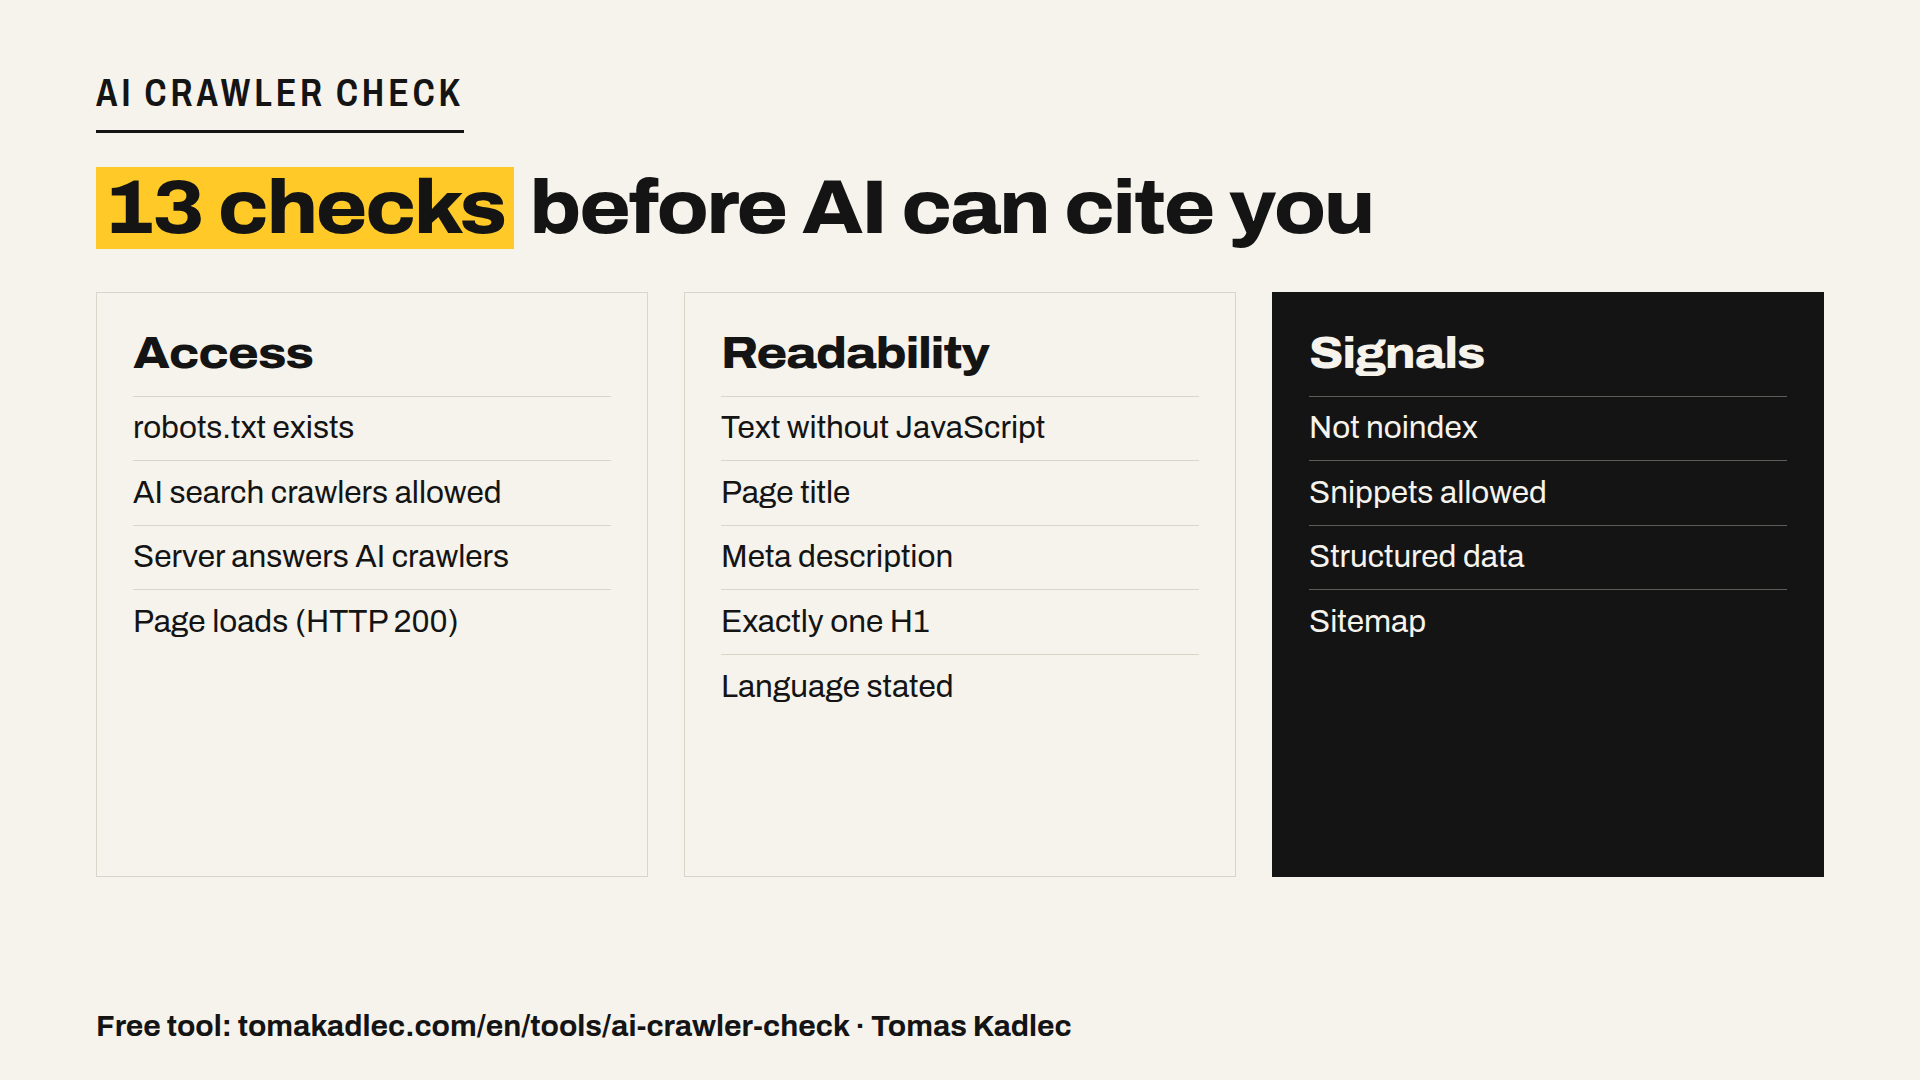
Les 13 contrôles, en trois groupes
Accès : le robot peut-il entrer ?
- Le fichier robots.txt existe. Un fichier fonctionnel à la racine du domaine. S'il manque ou s'il est cassé, le comportement des robots devient imprévisible.
- Les robots de recherche IA sont autorisés. L'outil lit le robots.txt pour 16 robots d'IA. Les plus importants pour la visibilité sont les robots de recherche comme OAI-SearchBot, Claude-SearchBot et PerplexityBot. Ils récupèrent les pages pour les réponses de la recherche IA.
- Le serveur répond aux robots d'IA. Certains pare-feu et protections anti-bots refusent toute requête contenant « GPTBot » ou « ClaudeBot ». Le robots.txt dit oui, le serveur répond 403. L'outil envoie des requêtes avec ces noms et compare la réponse à celle d'un navigateur normal.
- La page se charge. HTTP 200. Cela paraît évident, mais j'ai vu des chaînes de 301 et des 404 sur des pages qui « marchent dans le navigateur ».
Lisibilité : comprend-il la page ?
- Texte lisible sans JavaScript. La plupart des robots d'IA n'exécutent pas le JavaScript. Si votre contenu n'apparaît qu'après le chargement des scripts, le robot voit une coquille vide. L'outil compte les mots présents dans le HTML lui-même.
- Titre de la page.
- Meta description.
- Un seul H1.
- Langue indiquée dans la balise html.
Signaux : a-t-il le droit d'utiliser ce qu'il a lu ?
- Pas de noindex. Un noindex oublié depuis un site de préproduction tue la page pour la recherche classique comme pour la recherche IA.
- Extraits autorisés. nosnippet ou max-snippet:0 limite ce que la recherche IA peut citer de vous.
- Données structurées. Du JSON-LD schema.org pour ce qu'est la page : Organization, Person, Product, Article, FAQPage.
- Sitemap. Un sitemap.xml, idéalement mentionné dans le robots.txt.
Entraînement ou recherche : bloquer l'un, garder l'autre
Beaucoup de sites ont bloqué les « robots d'IA » en 2023 et 2024 avec une ligne par robot. Souvent, ils ont bloqué la mauvaise chose.
Les grands acteurs de l'IA ont des robots séparés. GPTBot collecte des données pour l'entraînement des modèles. OAI-SearchBot récupère des pages pour les réponses de la recherche ChatGPT. Anthropic a ClaudeBot pour l'entraînement et Claude-SearchBot pour la recherche. Google-Extended contrôle l'entraînement de Gemini, tandis que Googlebot reste votre robot de recherche habituel.
Vous pouvez donc dire non à l'entraînement et oui aux citations :
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
L'outil affiche chaque robot avec son rôle (entraînement, recherche ou requête d'un utilisateur), pour que vous voyiez ce que votre robots.txt décide vraiment.
Deux limites, honnêtement. OpenAI et Perplexity indiquent que leurs récupérations déclenchées par un utilisateur (ChatGPT-User, Perplexity-User) peuvent ne pas suivre le robots.txt, puisqu'une personne a demandé la page. Et les requêtes de test partent de mon serveur, pas des adresses IP des robots. Un CDN qui vérifie les IP des robots peut donc répondre autrement.
À faire cette semaine
- Lancez le contrôle sur votre page d'accueil et sur votre page qui rapporte le plus.
- Corrigez d'abord chaque ligne rouge : robots de recherche bloqués, refus du serveur, noindex, pages vides sans JavaScript.
- Puis les jaunes : données structurées, description, un seul H1, sitemap.
- Décidez pour les robots d'entraînement en connaissance de cause, pas par accident.
- Relancez-le après chaque changement important du site. Plugins et réglages de CDN modifient le robots.txt et les en-têtes sans vous prévenir.
En bref
La visibilité dans l'IA commence avant le contenu. Si les robots ne peuvent pas entrer ou lire la page, rien d'autre ne compte. 13 contrôles, la plupart des corrections prennent quelques minutes.
Lancez le contrôle gratuit : AI crawler check sur tomakadlec.com. Une URL, sans inscription. Le rapport complet avec les corrections arrive par e-mail si vous le souhaitez. Si un point échoue et que vous voulez le faire corriger, voyez la réparation de la lisibilité IA.
Lequel des 13 contrôles votre site va-t-il rater, à votre avis ?
Sources : test de l'AI crawler check sur tomakadlec.com, 11 novembre 2026 (12 sur 13 à 14 h 35, 13 sur 13 à 14 h 46) · liste des robots vérifiée le 11 novembre 2026 dans la documentation d'OpenAI, d'Anthropic et de Perplexity · RFC 9309 (Robots Exclusion Protocol).